Иллюзия цифровой неуязвимости развеялась над песками Персидского залива. Налеты беспилотников на объекты крупных технологических компаний в регионе, включая инфраструктуру дата-центров в Бахрейне и ОАЭ, впервые заставили международный бизнес осознать: соглашения об уровне обслуживания (SLA) не защищают от физических средств поражения. Технологический сектор годами продавал идею бесплотного цифрового эфира, но у любого дата-центра есть точные географические координаты и вполне уязвимый наземный периметр.
За физическими рисками неизбежно следует юридическая трансформация. Если дата-центр хранит критические базы данных и подвергается риску атаки, отношения между провайдером и клиентом резко меняются. В договорах и нормативных документах на первый план выходят расширенные формулировки форс-мажора, освобождающие операторов от ответственности при внешних воздействиях.
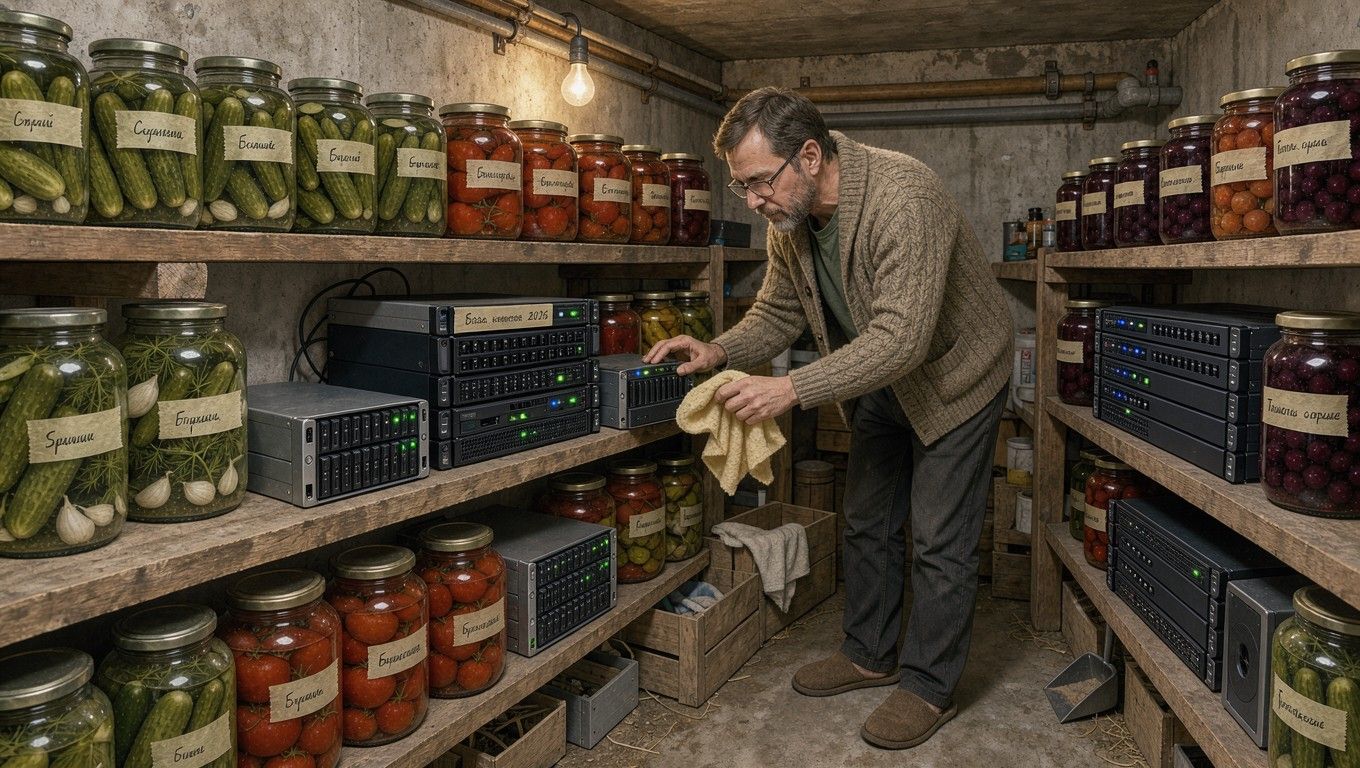
Когда риски доходят до вычислительной инфраструктуры, инженерная логика возвращается к фундаментальным основам: если чужой сервер может в любой момент стать недоступным из-за внешнего инцидента, единственный способ гарантировать выживание бизнеса — держать критические данные в собственном контролируемом контуре.
От Страсбурга до Владимира: география уязвимости
Конструктивная уязвимость дата-центров — проблема системная. Концентрация огромных вычислительных мощностей на ограниченном периметре ради оптимизации энергопотребления и снижения издержек создает критическую точку отказа.
В марте 2021 года в Страсбурге произошел масштабный пожар в дата-центре компании OVHcloud. Согласно официальному отчету французского бюро расследований BEA-RI, возгорание началось ночью в здании SBG2 в помещениях с источниками бесперебойного питания и аккумуляторными батареями. На объекте отсутствовала система автоматического пожаротушения, а конструктивные особенности здания способствовали стремительному распространению пламени. Приказ на отключение внешнего электроснабжения отдали оперативно, однако из-за работы батарей и внутренних генераторов площадка стала электрически безопасной для масштабной работы пожарных лишь спустя полтора часа. Здание SBG2 было полностью уничтожено, соседние корпуса получили повреждения, а миллионы интернет-ресурсов временно или безвозвратно прекратили работу, так как у многих клиентов резервные копии находились на соседних стойках в том же комплексе.
Спустя пять лет инженерные риски дополнились прямыми кинетическими угрозами. В октябре 2026 года с этим столкнулся российский технологический сектор. Серия атак беспилотников за четыре дня затронула три ключевые площадки «Яндекса». В ночь на 8 октября пострадал дата-центр в Сасове Рязанской области: из-за пожара работа комплекса была полностью остановлена, что повлекло недоступность зоны Yandex Cloud ru-central1-b. Утром 9 октября повреждения получили модули на площадке в Калуге. В ночь на 11 октября полностью прекратил работу дата-центр во Владимире, вызвав перебои в зоне ru-central1-a.
В Сасове и во Владимире традиционно размещались вычислительные кластеры компании, включая суперкомпьютеры «Червоненкис», «Ляпунов» и «Галушкин». Официальных подтверждений степени повреждения или сохранности этих машин оператор не публиковал, однако одновременное выпадение двух зон доступности перевело платформу Yandex Cloud, насчитывающую свыше 64 000 клиентов, в аварийный режим. Выдача новых квот на ресурсы была заморожена, кластеры управляемых баз данных перешли в режим чтения, а компания рекомендовала пользователям задействовать резервные планы восстановления на внешних площадках.
Юридическая броня: форс-мажор на все случаи жизни
Параллельно с техническими сбоями началась масштабная перестройка договорных условий на всем рынке облачных услуг. Провайдеры поняли: старые регламенты возмещения ущерба в новой реальности несут экзистенциальную угрозу для их собственного бизнеса.
10 октября «Яндекс» обновил пользовательское соглашение, официально включив в список обстоятельств непреодолимой силы террористические акты и военные действия с применением БПЛА, ракетного вооружения, боеприпасов и их частей, а также взрывы, обстрелы и крупные техногенные аварии.
Следом за лидером рынка условия пересмотрели и другие игроки. 16 октября 2026 года новую редакцию оферты представил сервис Selectel. Документ продемонстрировал классический пример аппаратного снижения финансовой ответственности. Согласно пункту 6.2 соглашения, ответственность исполнителя за любые убытки теперь ни при каких обстоятельствах не может превышать стоимости услуг за тот календарный месяц, в котором произошло нарушение. Косвенные убытки и упущенная выгода традиционно исключены.
Но куда более примечательным стал пункт 6.4 обновленной оферты. Исполнитель прямо освободил себя от ответственности за убытки, возникшие вследствие принятия органами власти нормативных актов или решений, которые «ограничивают или приостанавливают деятельность Исполнителя». При этом перечень обстоятельств непреодолимой силы сформулирован максимально широко: в него вошло само «издание нормативных актов или индивидуальных предписаний государственными органами». Не актов, объективно препятствующих исполнению обязательств, а сам факт нормотворчества в целом.
Этот юридический маневр имеет под собой вполне конкретные основания. 24 августа 2026 года президент подписал указ № 604, регламентирующий введение временного управления на объектах критической инфраструктуры через структуры Росимущества, если владелец не обеспечил надлежащую безопасность своего объекта от внешних нападений. В случае возникновения претензий со стороны регулятора частный оператор может оказаться под внешним управлением, а его клиенты останутся наедине с договором, по которому провайдер заранее снял с себя ответственность за любые решения государственных органов.
Математика катастрофы: почему RAID-5 гарантирует потерю данных
Осознание юридической беззащитности в публичных облаках подталкивает бизнес к развертыванию собственных мощностей. Однако при самостоятельной сборке серверного хранилища администраторы часто совершают классическую ошибку: в целях экономии собирают массив на базе архитектуры RAID-5. На современных дисках высокой плотности эта схема становится критической уязвимостью.
Схема RAID-5 рассчитывалась во времена накопителей емкостью в сотни мегабайт. В ней блоки данных распределяются по дискам, а один блок отводится под контрольную сумму четности (XOR). При выходе из строя одного накопителя массив продолжает работу в деградированном режиме, вычисляя недостающие байты «на лету».
Однако физика магнитной записи упирается в параметр URE (Unrecoverable Read Error) — статистическую вероятность невосстановимой ошибки чтения. Для стандартных накопителей потребительского класса этот порог по паспорту составляет 1 ошибку на 10¹⁴ прочитанных бит, что соответствует примерно 12,5 ТБ данных. Для накопителей корпоративного уровня планка надежности выше — 10¹⁵ бит (около 125 ТБ).
Если в массиве RAID-5 из четырех современных дисков по 16 ТБ отказывает один накопитель, для его восстановления контроллер должен прочесть каждый сектор на трех оставшихся исправных дисках — суммарно 48 ТБ данных. При паспортном пороге URE 10¹⁴ вероятность встретить нечитаемый сектор на таком массиве при ребилде чрезвычайно высока.
Поскольку запасной четности в деградированном RAID-5 уже нет, любая ошибка чтения на выживших дисках делает восстановление соответствующего страйпа невозможным. В зависимости от типа контроллера перестроение либо прерывается с полным крушением массива, либо оставляет нечитаемые сектора внутри файловой системы.
Кроме того, диски в корпоративные серверы обычно покупают одной партией, монтируют в одну корзину с равным тепловым и вибрационным режимом. При выходе из строя одного диска остальные имеют аналогичную степень износа. Нагрузка линейного чтения при ребилде на накопителях емкостью 16–20 ТБ растягивается на 48 часов и более. Под таким стрессом диск с деградирующим блоком магнитных головок легко выходит из строя, превращая массив в невосстановимый набор микросхем.
Свою роль играет и отсутствие поддержки TLER (Time-Limited Error Recovery) в потребительских винчестерах. При возникновении проблемного сектора настольный диск пытается вычитать его на протяжении десятков секунд. Программный RAID в Linux или аппаратный RAID-контроллер с тайм-аутом ожидания в 30 секунд расценивают эту задержку как зависание устройства, принудительно сбрасывают шину и исключают диск из пула.
Для жестких дисков объемом более 4–8 ТБ минимальным техническим стандартом остаются конфигурации с двойной четностью — RAID-6, RAID-Z2, либо прямое зеркалирование уровня RAID-10, при котором нагрузка при восстановлении ложится только на один диск-зеркало.
Архитектура ZFS: ликвидация «дыры записи»
Создание надежного локального сервера опирается не только на правильный выбор накопителей, но и на файловую систему, устойчивую к внезапным отключениям питания. В традиционных массивах критическим уязвимым местом остается рассинхронизация при сбое записи, известная как write hole.
В классическом RAID обновление файла разделено на две операции: запись измененного блока данных и запись пересчитанного блока четности. Если между этими двумя командами пропадает электропитание, на дисках возникает скрытая несогласованность данных и четности. При последующем отказе любого диска попытка восстановить сектор через XOR сгенерирует поврежденную информацию. В серверных контроллерах этот изъян десятилетиями компенсировали установкой кэш-памяти NVRAM с резервными аккумуляторами (BBU).
Файловая система OpenZFS устраняет проблему программно, опираясь на парадигму Copy-on-Write (CoW). Фундаментальное правило ZFS: занятый блок никогда не перезаписывается на месте. Любая модификация информации приводит к тому, что обновленные данные пишутся исключительно в свободные сектора пула.
Вся иерархия данных в ZFS представляет собой дерево Меркла:
- Нижний уровень занимают блоки полезной нагрузки.
- Промежуточные узлы представляют собой блочные указатели, которые содержат физический адрес потомка и его 256-битную контрольную сумму. Контрольная сумма хранится в родительском узле, что исключает ситуацию, когда поврежденный блок маскирует собственную деградацию.
- В корне всей структуры находится базовый указатель —
uberblock.
При записи файла система размещает новые блоки в свободном пространстве, формирует новые родительские указатели с обновленными контрольными суммами и каскадом перестраивает дерево снизу вверх. Финальное действие — единственная атомарная операция записи нового uberblock в специальное кольцо меток накопителя. До этой миллисекунды старое дерево метаданных остается абсолютно целым и активным. Если сервер полностью обесточить в середине процесса, данные не разрушатся: пул просто смонтируется в состоянии последней зафиксированной группы транзакций (txg). Утилита восстановления целостности структуры fsck в ZFS не предусмотрена, поскольку система не может находиться на диске в полуразобранном состоянии.
Реализация RAID-Z защищает от write hole за счет применения динамической ширины страйпа: каждый блок формирует собственный страйп требуемого размера, поэтому любая операция записи является полной (full-stripe write). При этом ZFS обеспечивает сквозной контроль целостности: при регулярной проверке массива (zpool scrub) система сверяет блоки с их контрольными суммами и при выявлении искажений (silent bit-rot) автоматически считывает корректные данные из блоков четности, исправляя дефект на лету.
Практика изолированного контура: от TrueNAS до сейфа
Построение собственного отказоустойчивого сервера сегодня доступно малому бизнесу и независимым специалистам без закупки громоздких промышленных шкафов. Базовый комплекс строится на компактных станциях под управлением специализированных ОС на базе OpenZFS (например, TrueNAS CORE или TrueNAS SCALE) либо на сетевых хранилищах класса Synology и QNAP при условии правильного конфигурирования пулов.
Надежный контур опирается на три технических элемента:
- Дисковый пул с двойной четностью (RAID-Z2 или зеркала vdev). Использование накопителей с поддержкой протоколов TLER или ERC предотвращает выпадение дисков из массива при временных задержках чтения.
- Неизменяемые локальные снапшоты. Снимки состояния файловой системы в CoW-системах создаются мгновенно и не требуют физического дублирования блоков. Снапшот фиксирует ссылки на состояние дерева транзакций, поэтому ни атака вредоносного ПО, ни ошибка администратора не могут изменить защищенную версию данных.
- Блочная репликация ZFS send/receive. В отличие от файлового копирования через rsync, которое требует полного обхода структуры каталогов, механизм репликации ZFS передает между системами сырые блочные срезы на уровне зафиксированных транзакций. Процесс происходит асинхронно, с сохранением компрессии LZ4 и проверкой контрольных сумм на стороне приемника.
Финальным рубежом надежности остается классическое правило резервного копирования 3-2-1: три копии информации, на двух различных типах носителей, одна из которых находится за пределами основной рабочей площадки.
В условиях инфраструктурных рисков вынос копии во внешнее хранилище требует строгого физического воздушного зазора (air gap). Если резервная площадка постоянно доступна по сети через API или туннели, она делит риски с основным контуром.
Настоящая автономия обеспечивается съемными жесткими дисками или ленточными LTO-картриджами. Носитель подключается к системе исключительно на время проведения циклического бэкапа, верифицируется контрольными суммами, после чего физически отключается, упаковывается в защитный кейс и отправляется на хранение в огнестойкий сейф в географически удаленном здании. К этому архиву невозможно получить удаленный доступ через уязвимости веб-интерфейсов, его нельзя обесточить вместе с подстанцией, и он не зависит от изменений в правилах предоставления услуг сторонних компаний.
Что это значит
События 2026 года обозначили структурный сдвиг в подходах к проектированию ИТ-инфраструктуры. Эра безоговорочного делегирования всех ресурсов в публичные облака уперлась в физические и правовые ограничения.
Дата-центры представляют собой концентраторы рисков не только из-за внутренних технологических факторов, но и в силу уязвимости перед внешними воздействиями. Внесение пунктов о форс-мажоре при ударах БПЛА в пользовательские соглашения и ограничение ответственности провайдеров в пределах месячной стоимости услуг четко определили правила игры: операционные и финансовые последствия остановки сервисов бизнес несет самостоятельно.
Локальный сервер на базе ZFS с физически изолированными резервными копиями перестал быть решением исключительно для энтузиастов. Для малых и средних предприятий это прямой инструмент снижения бизнес-рисков. Если критические данные невозможно отключить от глобальной сети и запереть в сейфе, гарантий их сохранения в современных условиях не дает ни один договор.
Ну конечно
1. Ministère de la Transition écologique et de la Cohésion des territoires : Rapport d’enquête sur l’incendie au sein du centre de stockage de données OVH situé à Strasbourg (67) le 10 mars 2021
2. Хоть под землю провались. Что предпринять "Яндексу" и другим владельцам ЦОД для защиты от БПЛА | ComNews
3. Yandex Cloud работает в аварийном режиме после атак на три дата-центра Яндекса / Хабр
4. Эвакуация за один день: как я перенёс два приложения и детектив-ARG из облака под ударами на собственный VPS / Хабр
5. Cross-Site Disaster Recovery | TrueNAS Documentation Hub
6. ZFS: архитектура, особенности и отличия от других файловых систем / Хабр
7. RAID-Z (Jeff Bonwick's Blog)
8. Copy-on-Write — OpenZFS documentation
9. Is RAID 5 dead? URE risk on rebuild, explained | Servnet UK
10. Why Rebuilding a Degraded RAID Destroys Data | Rossmann Group
11. Стратегия резервного копирования 3-2-1: технический разбор / Хабр
12. Домашнее облако: как я построил цифровой «бункер» для важных данных / Хабр
Комментарии (0)