В каждой шутке есть доля правды - с детства я слушал это выражение и за свою жизнь имел возможность много раз его подтвердить. Так и в этот раз мне прислали шутку про то, что языковые модели не умеют говорить на Шотландском, а я с мыслью «да ладно» пошел изучать вопрос и на моей лысой голове зашевелились волосы.
В статье про Гекльберри Финна я сравнивал короля-самозванца, который на ходу сочиняет греко-еврейскую этимологию слова «оргия», с языковыми моделями: гладкая, уверенная, полностью выдуманная справка, которой верят авторитетности утверждения. Но в этой истории всё ровно наоборот. Не машина выдумала язык, а человек. Машины потом пришли и выучили по написанному.
Оказалось для меня, что эту историю в 2020 году пересказали очень многие. А вот чем она закончилась к осени 2026-го, и во что она выросла знают не все, да и историю, кажется. забыли.
Сначала про язык, иначе ничего не понятно
Как я выяснил для себя - Шотландский (Scots) — германский, ближайший родственник английского, со своей лексикой, грамматикой и орфографией. В переписи 2022 года 1 508 540 человек ответили, что говорят на нём, — больше четверти населения Шотландии. ЮНЕСКО относит его к уязвимым языкам. А с 30 ноября 2025 года Scots впервые в истории получил статус официального языка Шотландии.
Двенадцать лет, словарь и семь лет упорства
Шотландская Википедия существует с 23 июня 2005 года. Проблемы с качеством у неё были видны давно: ещё в 2014 году писали, что раздел читается как расшифровка речи человека с шотландским акцентом, а один из редакторов Википедии всерьёз предлагал раздел закрыть, решив, что это розыгрыш.
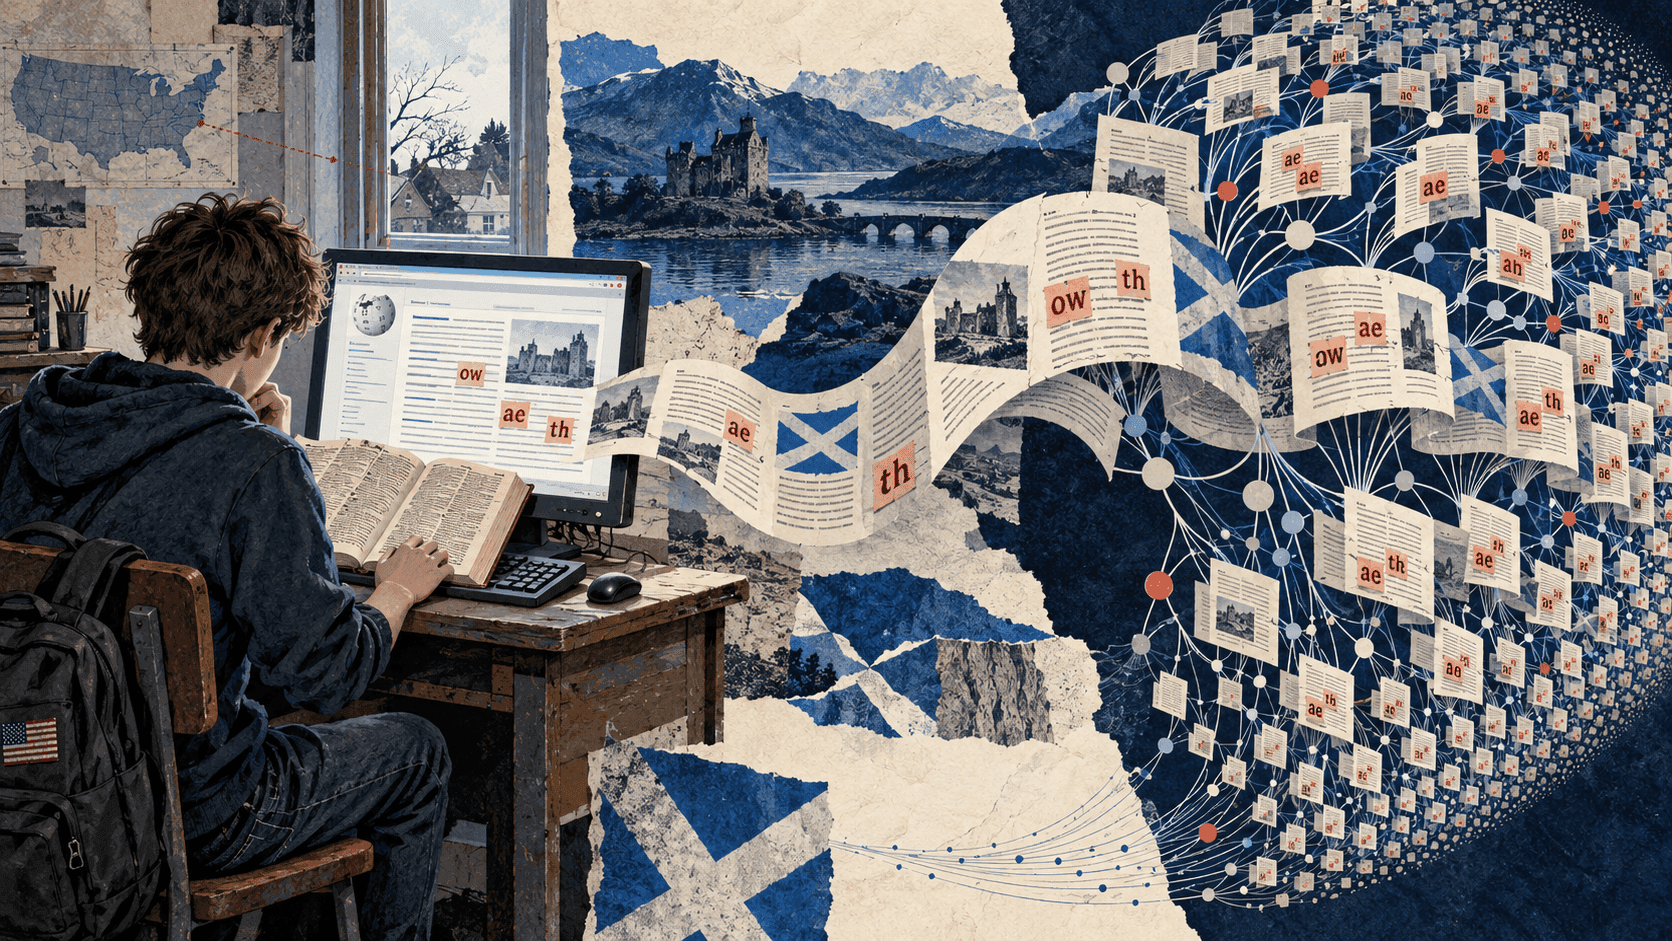
В 2013 году к разделу присоединился двенадцатилетний мальчик из Северной Каролины под ником AmaryllisGardener. Шотландского он не знал. Метод у него был простой: взять статью из английской Википедии, найти отдельные слова в онлайн-словаре Scots и подставить вместо английских. Грамматику он не трогал, потому что не знал её. Если слова в словаре не находилось, оставалось английское.
Мальчик был упорный и делал он это семь лет. Итог — около 23 тысяч статей, примерно треть всего раздела (по подсчётам разоблачителя — почти половина), и, по разным оценкам, от 160 до 200 тысяч правок.
Один из администраторов раздела потом объяснил это очень просто: раздел никому не был нужен, взялся тот, кто взялся, потому что больше никто не взялся, и никто ему ни разу ничего не подсказал. Так в жизни часто бывает.
Есть деталь, которую в пересказах обычно опускают. Другие редакторы, видя эти статьи, делали вывод, что Scots — это и есть английский с изменённым написанием, и начинали писать так же. То есть первыми на этих данных обучились не машины, а люди.
Разоблачение
В конце августа 2020 года пользователь Reddit с ником Ultach выложил в сообществе r/Scotland подробный разбор: почти все статьи шотландской Википедии написаны одним человеком, который языка не знает. Пост набрал около 18,7 тысячи голосов. Ultach назвал происходящее культурным вандализмом невиданного масштаба и предположил, что этот человек, возможно, нанёс языку больше вреда, чем кто-либо в истории. Аргумент был не про грамматику, а про восприятие: Википедия — один из самых посещаемых сайтов мира, и огромное число людей увидело под вывеской «шотландский» исковерканный английский и решило, что так и должно быть и фактически отдельного языка нет.
Дальше заработала машина интернета. Британская пресса выдала заголовки в диапазоне от «угона шотландского языка» до гардиановского «Shock an aw». Автора быстро нашли. Ему к тому моменту было девятнадцать лет.
Парень извинился. Написал, что начинал двенадцатилетним ребёнком, а в таком возрасте не видишь, как привычка становится вредной, что он не возражает, если все его правки откатят, статьи удалят, а его забанят там навсегда. И отдельно попросил прекратить травлю в соцсетях — его и его друзей, которые к Википедии вообще не имели отношения.
Что сделали дальше
Сообщество Википедии открыло обсуждение. Варианты были от «снести всё и начать с нуля» до массовой разметки и ручной проверки. Пошли по второму пути. Один из редакторов прогнал статьи по словнику шотландского правительства и нашёл около тысячи текстов с английскими словами, которых в Scots быть не должно. Директор Scots Language Centre Майкл Демпстер предлагал не сносить, а спасать: инфраструктура есть, нужны грамотные люди.
Грамотных людей нашлось немного. На специальный редактатон (или эдитатон, от англ. editathon = edit (редактировать) + marathon (марафон) — это совместное мероприятие, во время которого участники создают, дополняют и улучшают статьи в каком-либо онлайн-проекте или базе данных (чаще всего в Википедии) на заданную тему) по шотландской Википедии пришло около 30 человек. Напомню: исходный пост собрал 18,7 тысячи голосов. Возмутились — тысячи, чинить пришло — три десятка. Это нормальное соотношение для любого сообщества, про него не стоит никогда забывать наблюдая бурления масс.
Большую часть статей AmaryllisGardener удалили. Раздел статей сократился примерно с 55 тысяч в 2018 году до 40 тысяч статей в 2021-м. На сентябрь 2026 года в шотландской Википедии 34 255 статей, 116-е место среди всех языковых разделов и три администратора на 135 с лишним тысяч зарегистрированных учётных записей.
При чём тут машины
Через день после поста исследовательница в области обработки языка Робин Спир (тогда главный научный сотрудник компании Luminoso) обратила внимание на то, что популярные детекторы языка — cld2, cld3 и fastText — среди прочих умеют определять Scots, и представление о нём, по её мнению, берут как раз из Википедии. И сформулировала главное: если у вас мультиязычная модель, эта подделка вполне может быть всем вашим обучающим набором по шотландскому.
Детекторы здесь важнее, чем кажется. Большие веб-корпуса для обучения моделей раскладывают по языкам именно такими классификаторами. Если классификатор выучил, что шотландский — это английский с причудливым правописанием, то он и в остальном интернете будет искать «шотландский» по этому образцу. Ошибка в маленьком разделе корпуса данных для обучения перестаёт быть маленькой, когда этот раздел служит эталоном.
Для языка с небольшим количеством цифровых текстов Википедия часто оказывается одним из немногих доступных источников, и Quartz тогда же писал, что какие-то модели вполне могли строить всё своё понимание Scots на этой фальшивой версии. Там же компьютерный лингвист Дэвид Яровски предупреждал о более общей проблеме: когда системы машинного перевода учат на текстах, которые сами были машинным переводом, ошибки не исправляются, а усиливаются.
В популярных пересказах часто пишут, что на этих статьях обучались ранние версии GPT и поэтому «выучили искажённый шотландский». Подтверждения этому я не нашёл: в составе данных GPT-3 была английская Википедия, а состав данных большинства коммерческих моделей не раскрывается вовсе. Задокументирован механизм и конкретные инструменты вроде детекторов языка, а не конкретная модель, которая «отравилась».
Так же аккуратно со вторым популярным тезисом — что ИИ до сих пор плохо поддерживает шотландский из-за этого инцидента. Факт такой: на сентябрь 2026 года Google Translate поддерживает 249 языков, включая гэльский, мэнский и ямайский патуа, но Scots в этом списке нет. Связь с историей про подростка никто не доказал. Причин может быть много, в том числе та самая близость к английскому и отсутствие единой стандартной орфографии.
Пять лет спустя то же самое, но промышленно
Если бы история закончилась на шотландском, это был бы курьёз. Но в сентябре 2025 года MIT Technology Review выпустил большое расследование, из которого видно, что шотландский был не исключением, а ранней версией.
Норвежский компьютерный лингвист Тронд Тростеруд, который годами изучает маленькие разделы Википедии, называет определённый тип редакторов «угонщиками Википедии»: от наивных подростков, пишущих про родной город, до доброжелательных людей, уверенных, что помогают малому народу. Разница, по его словам, только в вооружении: раньше у них были словари, теперь у них агенты и языковые модели. AmaryllisGardener — классический угонщик со словарём. Сегодня тот же энтузиазм производит в разы больше текста, и выглядит этот текст гораздо правдоподобнее.
Гренландская Википедия к началу 2020-х насчитывала около 1 500 статей и со стороны выглядела как маленький успех. На деле почти все статьи написали люди, которые языка не знали. Большая часть из них были копипастой машинного перевода, а в одной из статей утверждалось, что в Канаде живёт 41 человек. Немец Кеннет Вер, который выучил гренландский и взялся за раздел, начал с того, что удалил почти всё. Потом несколько лет пытался найти носителей, готовых писать. Не нашёл. В сентябре 2025 года языковой комитет Википедии раздел закрыл, среди причин прямо назвав ИИ-инструменты, которые часто выдавали бессмыслицу, искажающую язык. Ирония в том, что гренландский при этом с 2024 года есть в списке языков Google Translate. А по данным того же расследования, ни Google Translate, ни ChatGPT не способны правильно посчитать по-гренландски до десяти.
В четырёх африканских разделах, по оценкам их же волонтёров, от 40 до 60% статей — неисправленный машинный перевод. В разделе на инуктитуте, по аудиту журналистов, такие фрагменты есть больше чем в двух третях содержательных страниц. Для фульфульде Google Translate переводит слово «январь» как «июнь», ChatGPT — как «август» или «сентябрь», а «урожай» превращается то в «лихорадку», то в «благополучие». Это язык, на котором активный редактор хочет давать фермерам советы про семена.
Масштаб зависимости. По оценке 2020 года, Википедия составляла больше половины обучающих данных для систем перевода с малагасийского, йоруба и шона. В 2022 году немецкие исследователи выяснили, что для 27 малоресурсных языков Википедия — единственный легко доступный источник текста в интернете. Даже английская Википедия, где редакторов в избытке, почти запретила встроенный инструмент автоперевода статей: около 95% созданных с его помощью статей не дотягивали до минимального стандарта без серьёзной доработки.
Петля замыкается так: человек, не знающий языка, переводит статью машиной → статья попадает в Википедию → следующая версия машины учится на этой статье → переводит ещё увереннее и ещё хуже → следующий человек, не знающий языка, этому верит. В июне я писал про работу Асемоглу о коллапсе знаний: там общий запас знаний истощается, потому что люди перестают вносить в него новое. Здесь сценарий злее. Запас и так крошечный, и пополняют его в основном те, кто не может проверить, что именно вносит.
Метрика, которая врала
Забавно не то, кто виноват, а то, как долго всё это выглядело успехом. И для многих продолжает выглядеть.
Шотландская Википедия ещё в 2008 году радовалась, что по числу статей обогнала маори и кашмирскую. В 2018-м в ней было 55 тысяч статей. Гренландская со своими полутора тысячами выглядела, по выражению авторов расследования, подтверждением того, что краудсорсинг работает даже в самых неожиданных местах. Все мерили количество. Количество росло. На качество не смотрели - не было экспертов.
Сегодняшние разговоры про ускорение всего и вся от разработки до бизнес-процессов и исключении из процесса людей - напоминают этот сюжет. Считать статьи — всё равно что считать строки кода или закрытые задачи: метрика растёт ровно до того момента, пока кто-то, кто разбирается в предмете, не заглянет внутрь. В шотландском случае заглянул один пользователь Reddit. В гренландском — один немецкий студент. Без них цифры продолжали бы расти.
Контрпример тоже есть, и он показательный. Инари-саамский, язык одной общины на севере Финляндии, сорок лет назад был на грани исчезновения: на нём говорили четверо детей. Сегодня носителей несколько сотен, есть школы с обучением на этом языке и 6 400 статей в Википедии, каждую из которых вычитал носитель. Википедию включили в школьную программу, а через неё в язык вводят новые слова для спорта, политики и видеоигр. Один из участников языковой ассоциации сформулировал их принцип коротко: «Нам не важно количество, нам важно качество». И добавил, что, возможно, хорошо, что для инари-саамского нет Google Translate. И здесь человек - решает.
Вместо вывода
Подросток из Северной Каролины не был злодеем. У него был словарь, энтузиазм и ничье пространство в сети. Сегодня энтузиазм у многих людей - тот же. Но вместо словаря у них агент, языковая модель и производительность труда, благодаря этим инструментам подрощенная в сотни раз. Изменился и читатель на той стороне. Раньше «шотландский» из Википедии читали люди, и часть из них хотя бы могла возмутиться. Теперь контент читают языковые модели агентов, которые языка тоже не знают и выучат данные как есть. Это самый прилежный и самый некритичный читатель из возможных.
Гренландское сообщество в итоге выбрало пустоту: лучше ничего, чем уверенная подделка. Шотландское выбрало чистку силами трёх десятков человек. А модели, кажется, ничего не выбирают и учатся на том, что есть.
Так что для маленького языка в эпоху ИИ на самом деле опаснее — когда о нём в интернете не написано ничего или когда о нём уверенно написано неправильно?

Комментарии (0)